導入 AI 視覺,一定要大量樣本嗎?
「我們不良品太少,湊不到幾千張影像,是不是就沒辦法用 AI?」這是很多產線導入前的疑慮。過去深度學習確實吃大量標註資料,但隨著遷移學習與 Edge AI 技術成熟,現在用少量樣本就能訓練出可用的模型,大幅降低導入門檻。
這篇用四個步驟,說明如何以少量樣本快速完成 Edge AI 訓練,讓視覺檢測更快落地產線。
為什麼是 Edge AI
Edge AI 指的是把 AI 推論放在產線邊緣的裝置上執行,而不是全部送到雲端。對工廠導入來說,這帶來幾個實際好處:
- 低延遲:推論在本地完成,反應快,跟得上產線節拍。
- 不依賴網路:離線也能運作,不怕廠房網路不穩。
- 資料留在廠內:敏感的製程影像不用外傳,較安全。
搭配少量樣本訓練,Edge AI 讓「快速、低門檻、可落地」變得可行。
少量樣本為什麼可行
用少量樣本還能訓練得動,靠的是幾項關鍵技術:
- 遷移學習(Transfer Learning):用在大型資料集預訓練好的模型當基礎,只微調最後幾層,少量樣本就能適應新任務。
- 資料增強(Data Augmentation):用旋轉、翻轉、調整亮度等方式,從幾張影像擴增出更多訓練資料。
- 異常偵測:只用「良品」影像訓練,讓模型學會正常樣貌,凡是偏離的就標為異常,特別適合不良品極少的情況。
少量樣本不是「用更少資料硬train」,而是換一套更聰明的方法,把有限的樣本價值放到最大。
四步驟快速導入
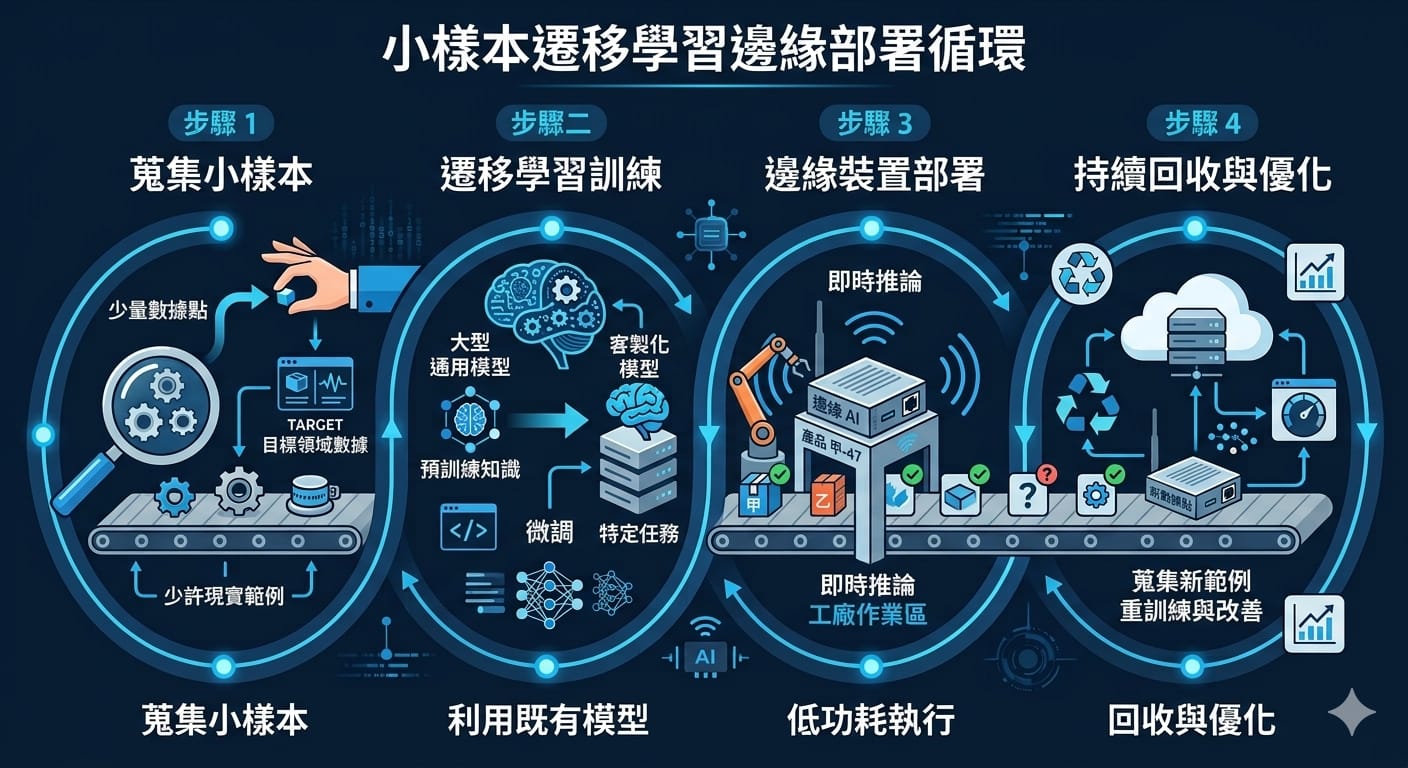
第一步:蒐集少量代表性樣本
不用追求數量,但要有代表性。盡量涵蓋良品的正常變異,以及手上現有的各類不良品。幾十到幾百張,搭配後續技術,通常就能起步。
第二步:用遷移學習快速訓練
以預訓練模型為基礎微調,搭配資料增強擴增樣本。這一步通常幾小時內就能得到第一版可測試的模型,而不是動輒好幾天。
第三步:部署到邊緣裝置
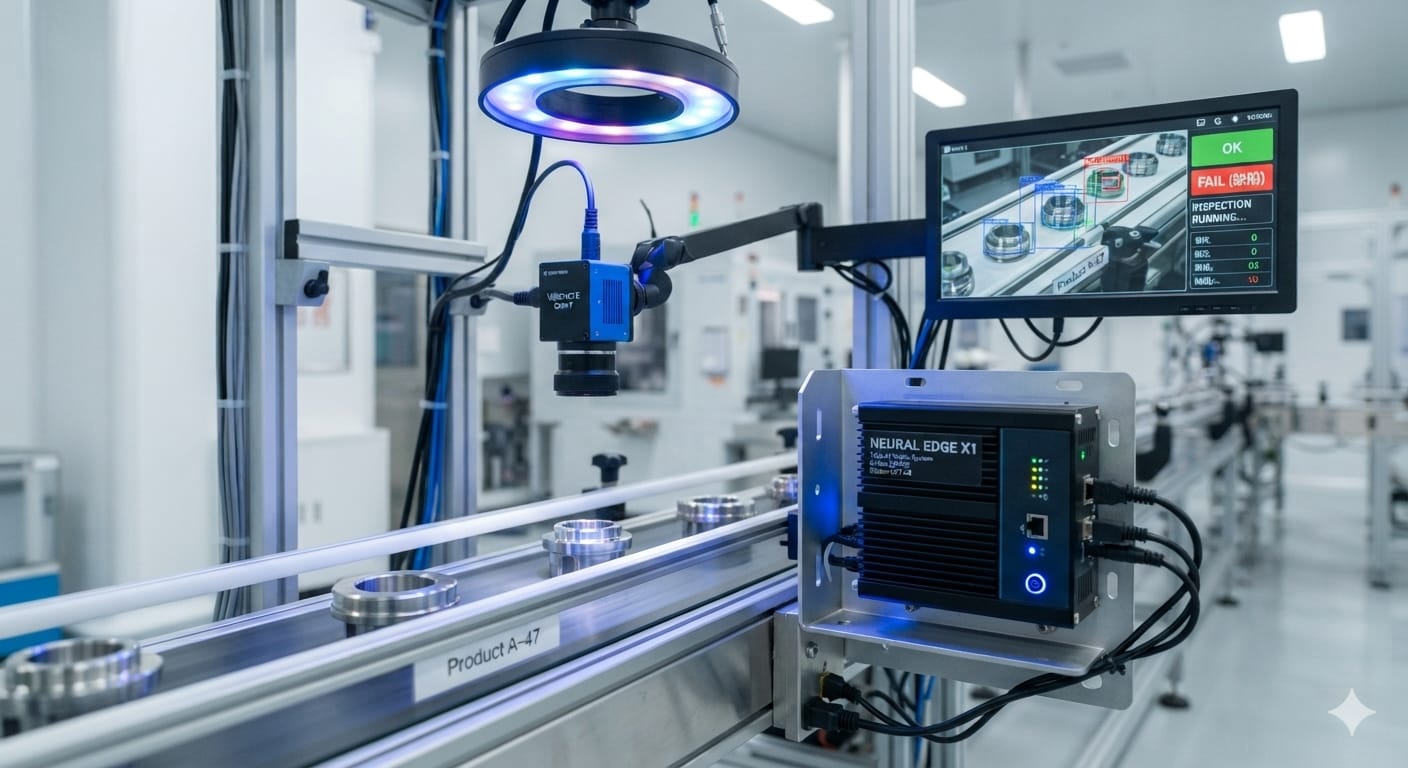
把訓練好的模型部署到產線旁的 Edge AI 裝置,接上相機與光源就能即時推論。邊緣裝置體積小、安裝快,不需大改產線。
第四步:持續回收與優化
上線後持續蒐集誤判與漏檢樣本,定期回訓模型。少量樣本起步,再靠回收機制讓模型越用越準,是 Edge AI 落地的關鍵節奏。
降低導入門檻的實務建議
想讓導入更快、更順,建議掌握幾個原則:
- 先求可用,再求完美:用少量樣本先做出堪用的第一版上線,靠實戰資料迭代,比一開始就追求完美更快見效。
- 選對場景試點:挑一個問題明確、樣本較好取得的環節先做,驗證後再擴大。
- 建立回收流程:上線第一天就把資料回收機制建好,別等問題累積才補。
- 軟硬體一起評估:邊緣裝置的算力要能撐住模型與節拍,選型時一起考量。
結語
少量樣本加上 Edge AI,把 AI 視覺的導入門檻大幅拉低。不必等到累積海量資料,也能快速做出可用模型、部署到產線、並在實戰中持續進步。對樣本難蒐集、想快速驗證的產線來說,這是務實又高效的切入方式。
如果你想用手上有限的樣本快速試做 Edge AI 視覺檢測,歡迎與我們聯絡,我們可以從樣本評估與試點場景開始,陪你加速落地。